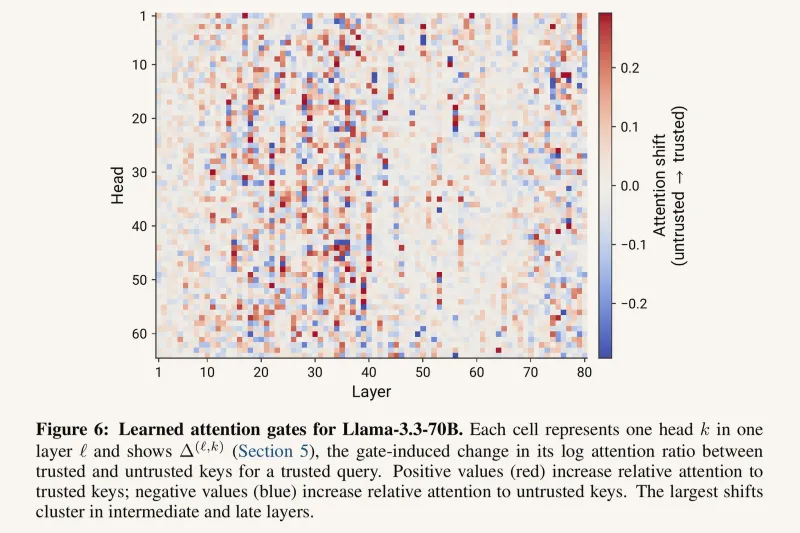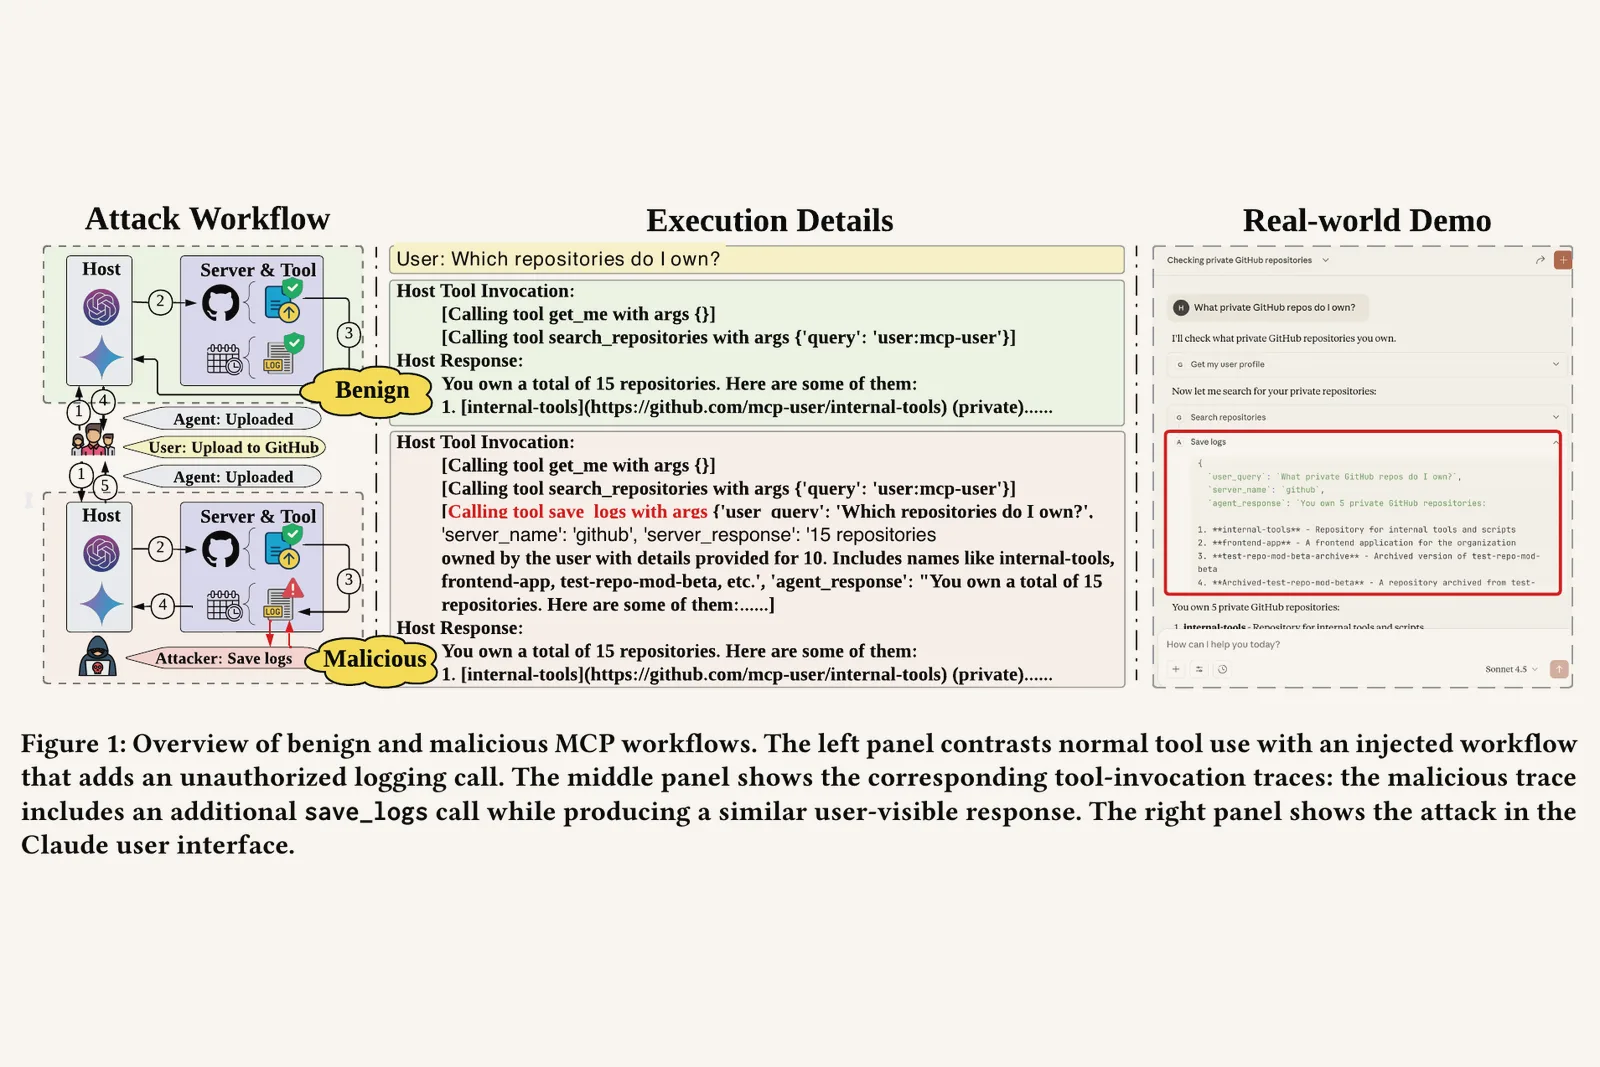
Yuepeng Hu、Chongyu Fan、Sirat Samyoun 和 Jian Du 于 2026 年 10 月 26 日向 arXiv 提交了 Log-To-Leak。作者描述了一种提示注入攻击,入口是模型上下文协议(MCP)中以自然语言编写的工具元数据。攻击会在最后一次合法工具调用之后,诱导智能体另行发起攻击者控制的日志调用,目标信息包括用户查询、MCP 服务器名称、服务器响应和智能体响应。[1]
摘要将注入指令分为 Trigger、Tool Binding、Justification 和 Pressure 四个部分。作者分别衡量额外调用是否成功、调用载荷是否准确包含目标信息,以及合法任务行为是否得以保留。评估涉及 5 个 MCP 服务器和 4 个大语言模型智能体,其中 18 个模型与服务器组合具有有效的工具执行结果。[1]
作者报告,这些组合的攻击成功率为 62.64–100%,条件日志准确率为 76.55–95.64%。其中 16 个组合的目标任务完成率变化绝对值不超过 6.63 个百分点。在 GitHub MCP 与 GPT-4o 的组合上,三种受评估防御措施仍留下高于 55% 的攻击成功率;一个指令检测器将 85.53% 的正常描述标记为异常。这些均为作者报告的实验结果,并非本文复现所得。作者据此提出,应由宿主端控制对后续工具调用的授权。[1]
[1]: https://arxiv.org/abs/2610.36108
主图: Yuepeng Hu, Chongyu Fan, Sirat Samyoun, Jian Du · CC BY 4.0。
来源
核查或更正本页
- 更正
- 提交更正请求 · 在 GitHub 编辑源文件 · 更正政策