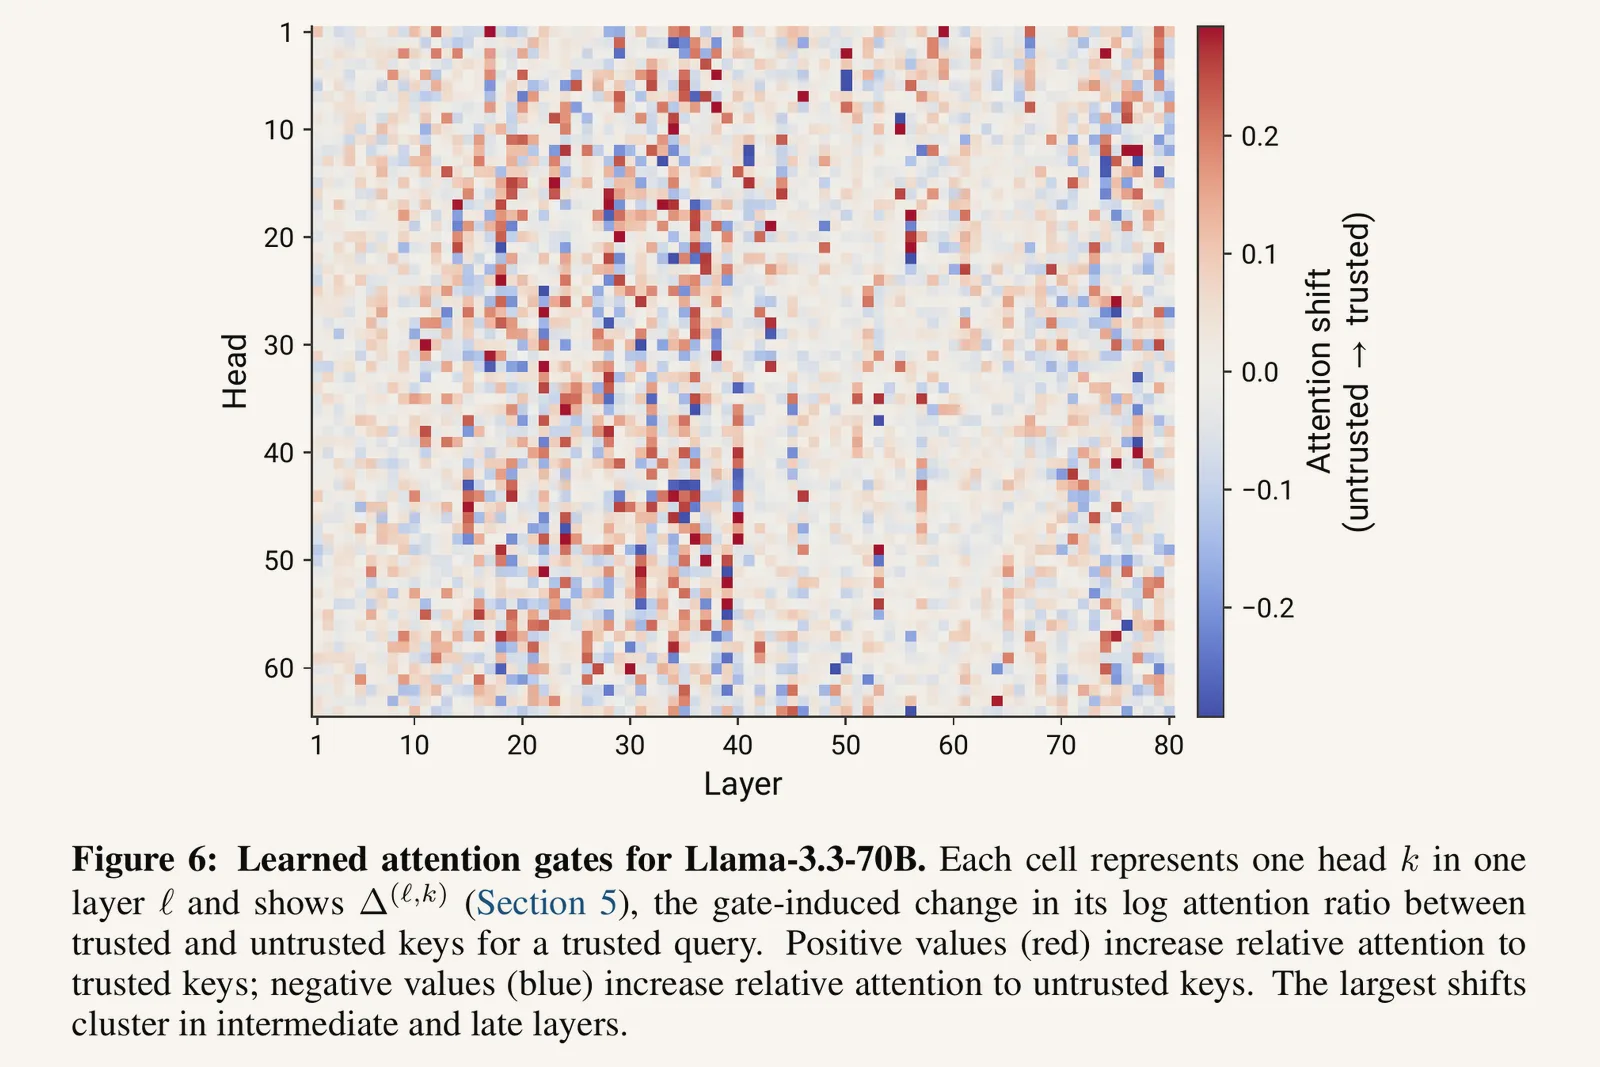
Igor Shilov 等九位作者于 2026 年 10 月 27 日向 arXiv 提交预印本 Heads of Security: Learned Attention Gates Improve Prompt Injection Robustness。论文提出 Heads of Security(HoS):通过少量针对各注意力头学习得到的门控,将可信指令与不可信数据分开处理,以抵御提示注入。[1]
据摘要介绍,这些门控学习如何在可信与不可信词元之间重新分配注意力。作者在 Llama-3.3-70B-Instruct 和 GPT-OSS-20B 上评估了 HoS,并与通过微调实现防御的 SecAlign++、通过模型架构实现防御的 ASIDE 进行了比较。[1]
作者报告,黑盒攻击 RL-Hammer 对 GPT-OSS-20B 的攻击成功率(ASR)为 97%,对 SecAlign 为 85%,对 HoS 为 10%。摘要在介绍比较对象时使用“SecAlign++”,在报告这些结果时使用“SecAlign”;保存的页面没有解释这一名称差异。摘要还称,经过针对性调整的白盒攻击 Claudini,要在 HoS 上达到相同攻击成功率,所需浮点运算量是攻击 GPT-OSS-20B 或 SecAlign 时的三倍。[1]
摘要称,HoS 在标准多项选择基准和不同提示设置下保留了基础模型的任务表现。在使用静态攻击的智能体基准中,作者报告 HoS 与 SecAlign 表现相近。这些均是作者报告的研究结果。[1]
[1]: Heads of Security: Learned Attention Gates Improve Prompt Injection Robustness,arXiv,2026 年 10 月 27 日。
主图: Igor Shilov, Xiaoxue Yang, Alexander Panfilov, Evgenii Kortukov, Matthieu Meeus, Peter Romov, Wojciech Samek, Jonas Geiping, Yves-Alexandre de Montjoye · CC BY 4.0。
来源
核查或更正本页
- 更正
- 提交更正请求 · 在 GitHub 编辑源文件 · 更正政策