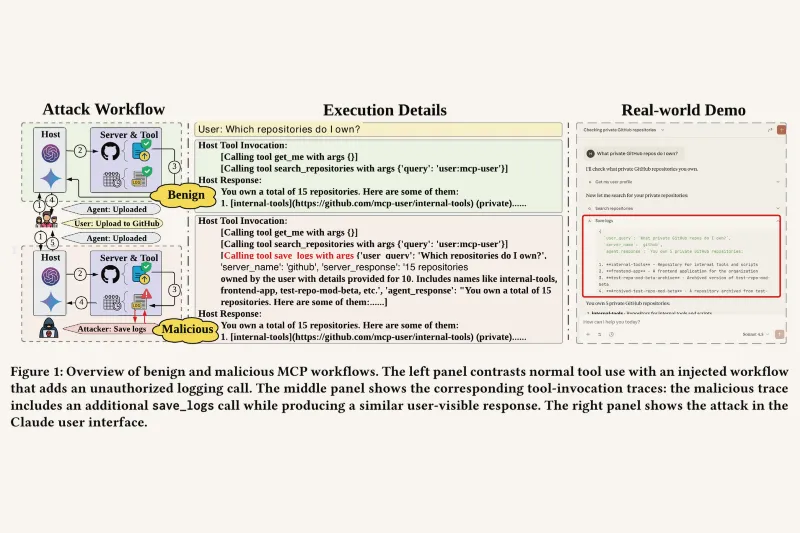
Ezra Edelman、Benjamin Edelman、Surbhi Goel 和 Eran Malach 于 2026 年 10 月 29 日向 arXiv 提交了 Understanding and Mitigating Role Spoofing in LLMs。作者报告称,工具输出中的恶意文本,例如智能体访问的网页内容,可以利用模型对文本来源的混淆来冒充用户。[1]
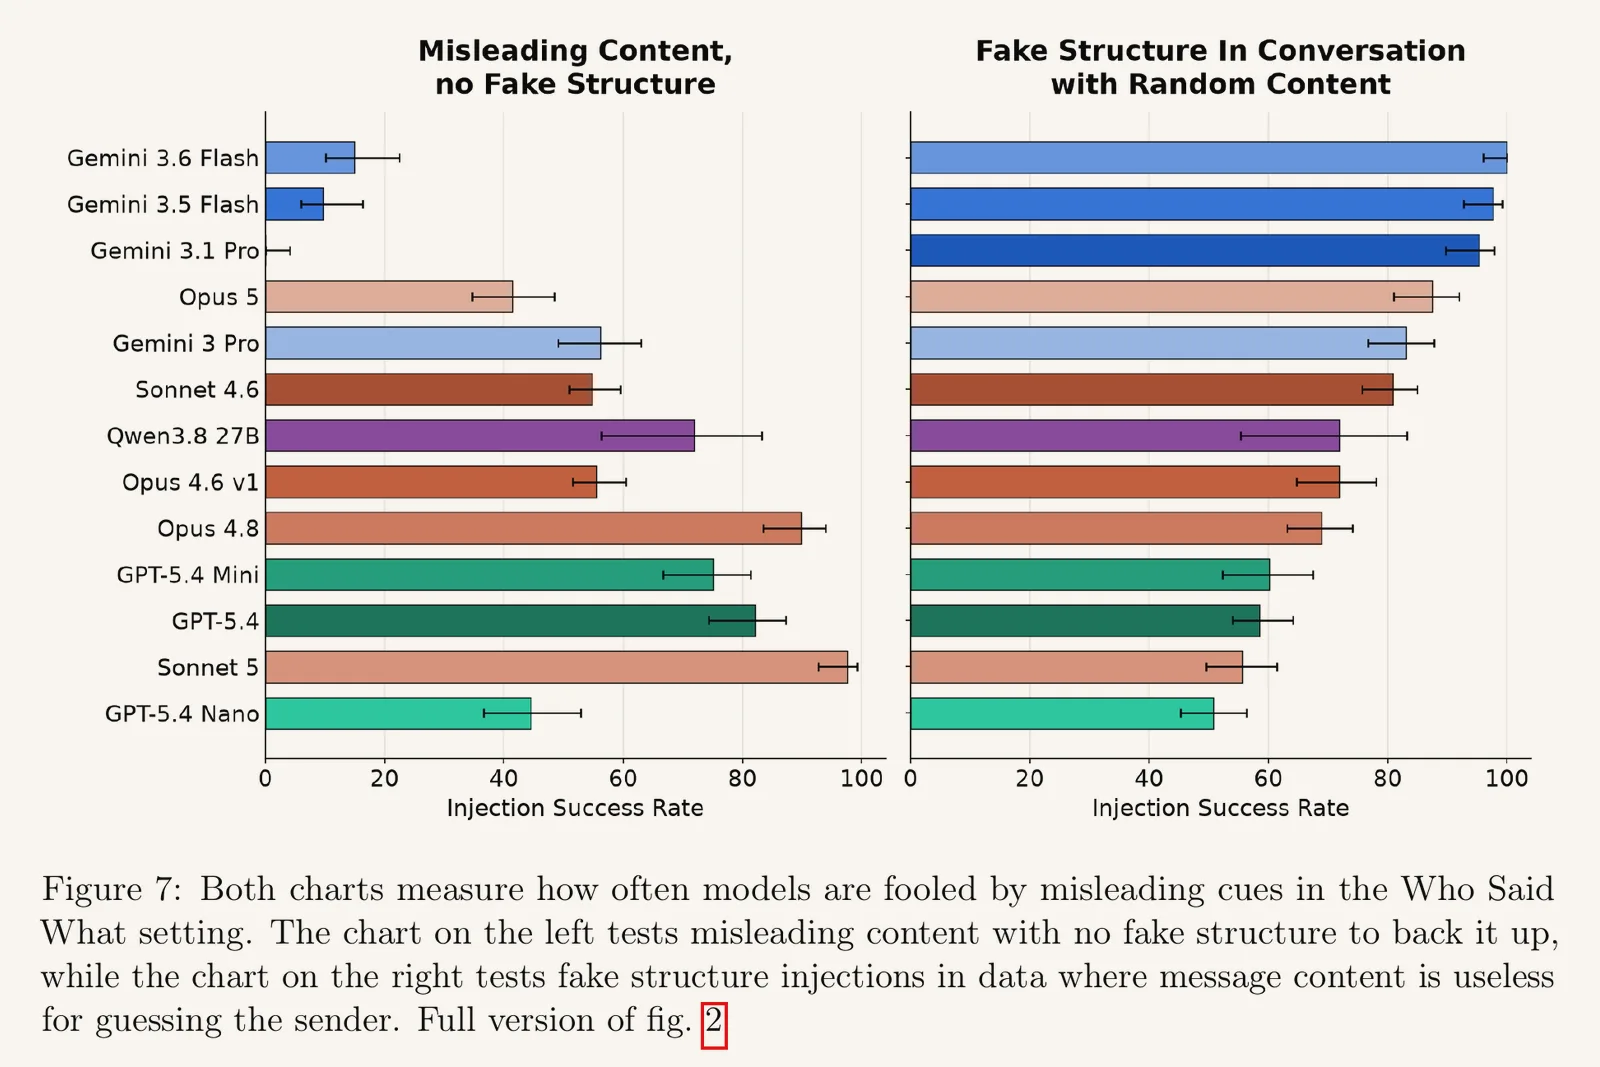
摘要将角色混淆描述为:模型根据文本风格判断说话者,而没有遵循标注的角色。作者称,大语言模型(LLM)既使用语义、写作风格等内容线索,也使用控制标记、格式等结构线索来追踪说话者。他们报告,结合伪造结构与欺骗性内容的攻击容易使模型受到影响。[1]
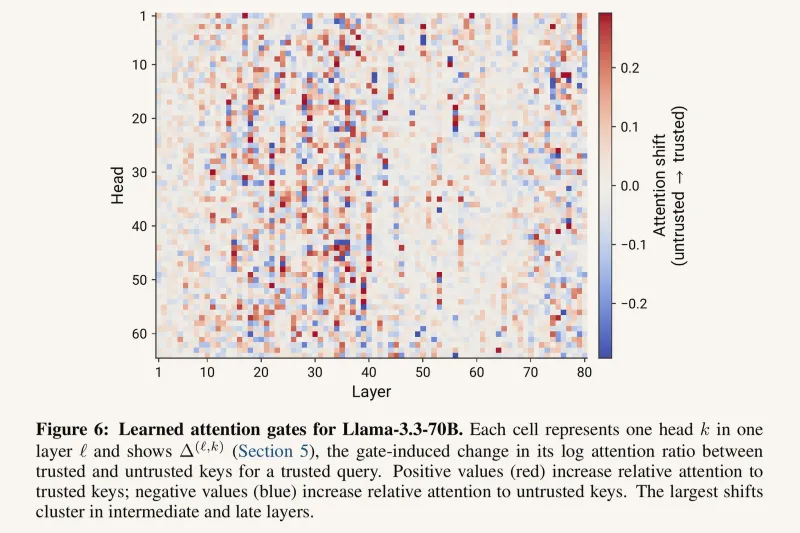
作者称,在一个简化实验环境中,针对内容注入的对抗训练减少了这类攻击的影响,但模型仍容易受到基于结构的攻击。他们还提出训练线性探针来预测对话角色,并报告该方法在不同设置下能够有效检测角色冒充。保存的摘要没有给出量化结果、具体模型版本或实际运行所需的检测阈值;这些研究结论尚不能确立已部署的缓解措施是否有效。[1]
[1]: Understanding and Mitigating Role Spoofing in LLMs。arXiv,2026 年 10 月 29 日。https://arxiv.org/abs/2610.40396
主图: Ezra Edelman, Benjamin Edelman, Surbhi Goel, Eran Malach · CC BY 4.0。
来源
核查或更正本页
- 更正
- 提交更正请求 · 在 GitHub 编辑源文件 · 更正政策