Sota Ogawa、Shojiro Yamabe、Daiki Nishiyama 和 Jun Sakuma 于 2026 年 11 月 6 日提交预印本,提出 TRACE-Edge,用于重建大语言模型(LLM)的有向谱系树。作者指出,审计外包微调、核查衍生模型的许可证合规情况,以及追踪从父模型继承的漏洞,都需要知道派生方向。保存的 arXiv 页面注明,论文正在 ICLR 2027 审稿中。[1]
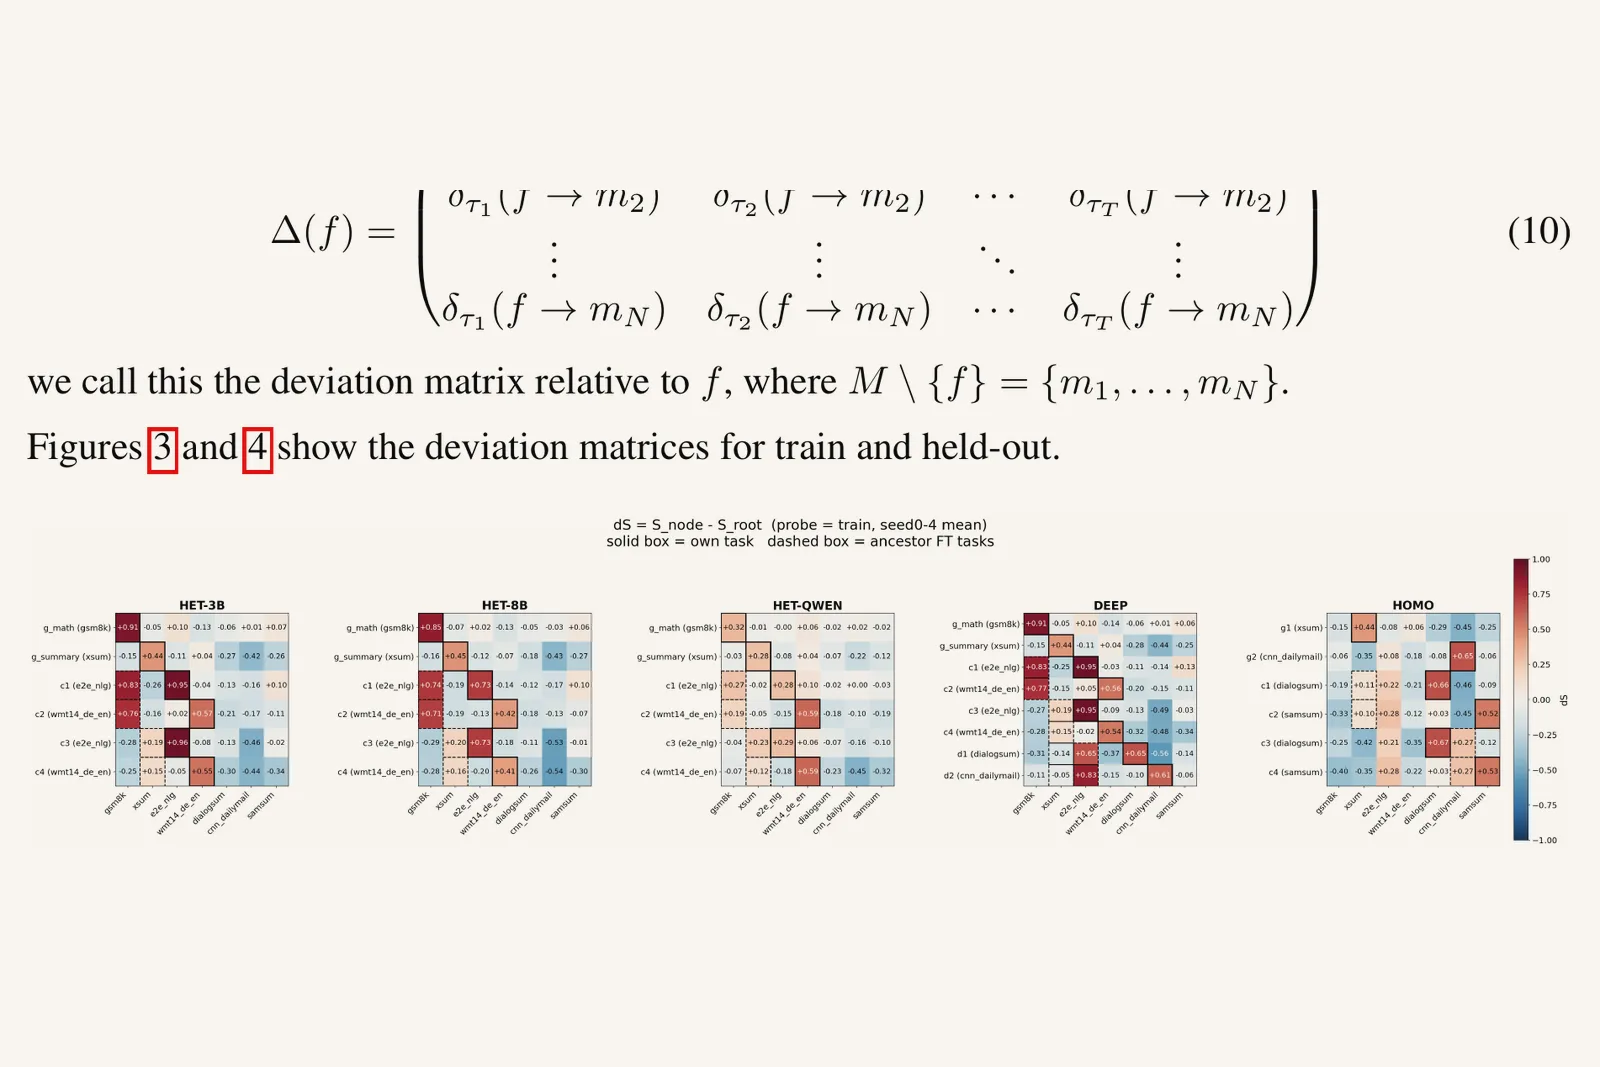
该方法采用灰盒访问:不查看模型权重,只观察教师强制条件下的对数似然,即模型对给定文本的评分。作者依据的现象是,微调会提高训练样本的对数似然,后代模型会继承这种变化。方法将模型之间具有方向性的不对称差异转化为边权,再求解包含内部节点的最大生成有向树,无需超参数或树结构约束。[1]
摘要报告的评估涵盖五种配置,共 25 棵模型树,涉及三个基础模型和七项任务。使用微调样本作为探测输入时,TRACE-Edge 的父节点匹配准确率为 0.74。作者还称,使用与训练数据同分布的留出样本时,该方法的平均表现优于输出相似度基线。精确求解加权树的最优化问题,并不意味着每个推断出的父节点都正确;报告的准确率仍是判断效果的重要边界。[1]
[1]: https://arxiv.org/abs/2611.08866
主图: Sota Ogawa, Shojiro Yamabe, Daiki Nishiyama, Jun Sakuma · CC BY-SA 4.0。
来源
核查或更正本页
- 更正
- 提交更正请求 · 在 GitHub 编辑源文件 · 更正政策