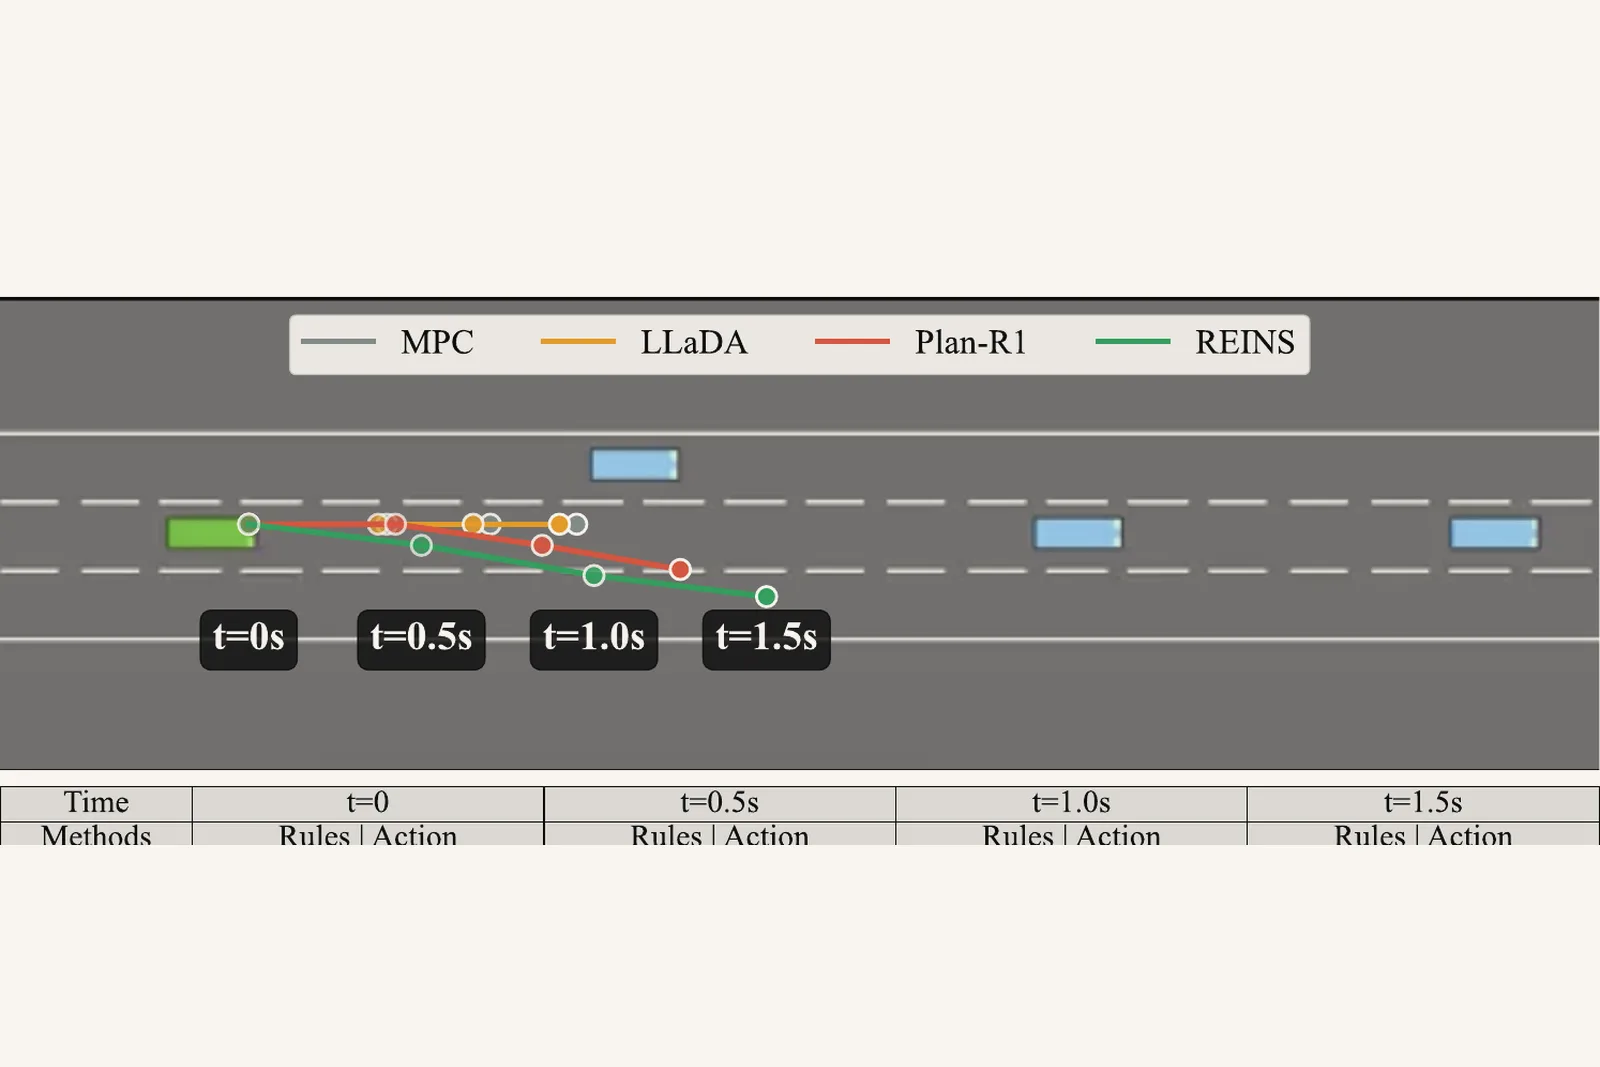
Zhihong Cui 等六位作者于 2026 年 11 月 7 日提交 REINS,提出一种运行时框架,让大语言模型(LLM)参与轨迹规划,同时由积累的规则处理熟悉场景。保存的 arXiv 页面将此次提交标为 v1。这是一项研究方案,性能结果来自作者报告。[1]
作者描述了 LLM 与规划器之间的三种衔接方式:以学习得到的变量级动力学模型约束模型建议,通过经过校准的判定条件和前向推演检查建议,再将通过检查的输出整合进带索引的规则记忆。熟悉场景通过查询记忆处理;新场景调用 LLM,并将通过检查的输出加入记忆。摘要称,查询的时间复杂度为 O(log n),整个过程不修改 LLM 权重。[1]
作者报告,在仿真和真实世界基准上,战术决策层的合规率超过 98%,碰撞减少近 50%,延迟为 1.9–4.6 毫秒。他们还称,随着记忆逐渐积累,LLM 调用率单调下降。保存的摘要没有给出合规率的定义、碰撞减少所比较的基线,也未说明延迟测量的起止范围,因此这些数字不足以确定读者自身部署的表现。[1]
[1]: REINS: A Self-Evolving Agent Harness for Real-Time Trajectory Planning。arXiv,2026 年 11 月 7 日。https://arxiv.org/abs/2611.10748
主图: Zhihong Cui, Hengyu Liu, Haoran Tang, Shijun Liu, Amir Taherkordi, Tor Skeie · CC BY 4.0。
来源
核查或更正本页
- 更正
- 提交更正请求 · 在 GitHub 编辑源文件 · 更正政策


