Burkay Tunçtürk、Koorosh Aslansefat、Yiannis Papadopoulos 和 Bao Nguyen 于 2026 年 11 月 4 日提交了一篇预印本,研究多个大语言模型(LLM)智能体协作是否会提高系统可靠性。作者认为,平均基准准确率遗漏了两个关键因素:系统部署后实际遇到的输入构成,以及合并各智能体答案的规则。[1]
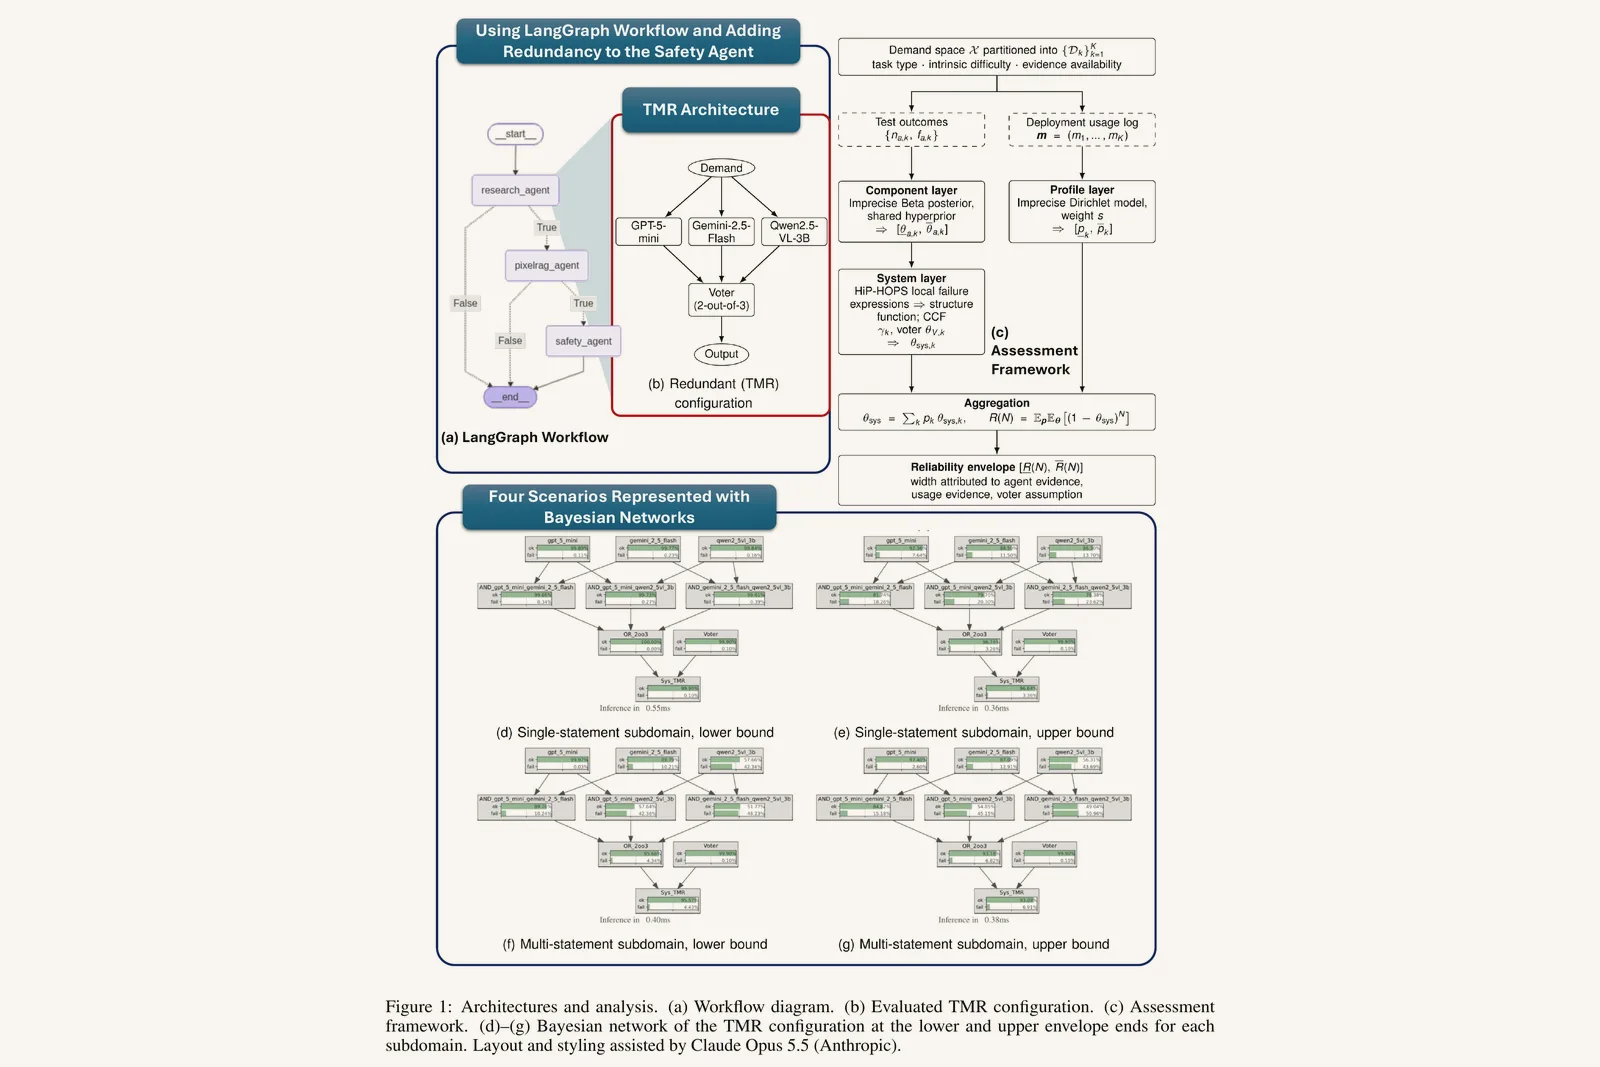
作者提出的框架以 HIP-LLM 为基础。摘要将 HIP-LLM 描述为针对单个 LLM 的分层不精确概率评估方法,新框架则将其与表示系统故障逻辑的贝叶斯网络结合。各智能体的故障概率区间经网络传播,形成可靠性范围。答案合并规则本身也可能失效,因此评估可以纳入这一环节的不可靠性。[1]
摘要报告称,在提取受监管化学危害声明的流水线中,三个模型采用多数投票,可以减轻最弱模型的影响,但表现并未明确超过最佳模型。作者还报告,如果投票环节在 5% 的请求中失效,它相对于中等模型的优势将大幅消失。这是一个有条件的结果,不能解读为已部署服务中观测到了 5% 的故障率。页面注明稿件已投稿至 IEEE Software Magazine,但这不代表已经获录用。[1]
[1]: arXiv,“More Agents, More Reliable? System-Level Reliability of Multi-Agent LLMs under Operational-Profile Uncertainty”,提交于 2026 年 11 月 4 日。https://arxiv.org/abs/2611.07140
主图: Burkay Tunçtürk, Koorosh Aslansefat, Yiannis Papadopoulos, Bao Nguyen · CC BY 4.0。
来源
核查或更正本页
- 更正
- 提交更正请求 · 在 GitHub 编辑源文件 · 更正政策


