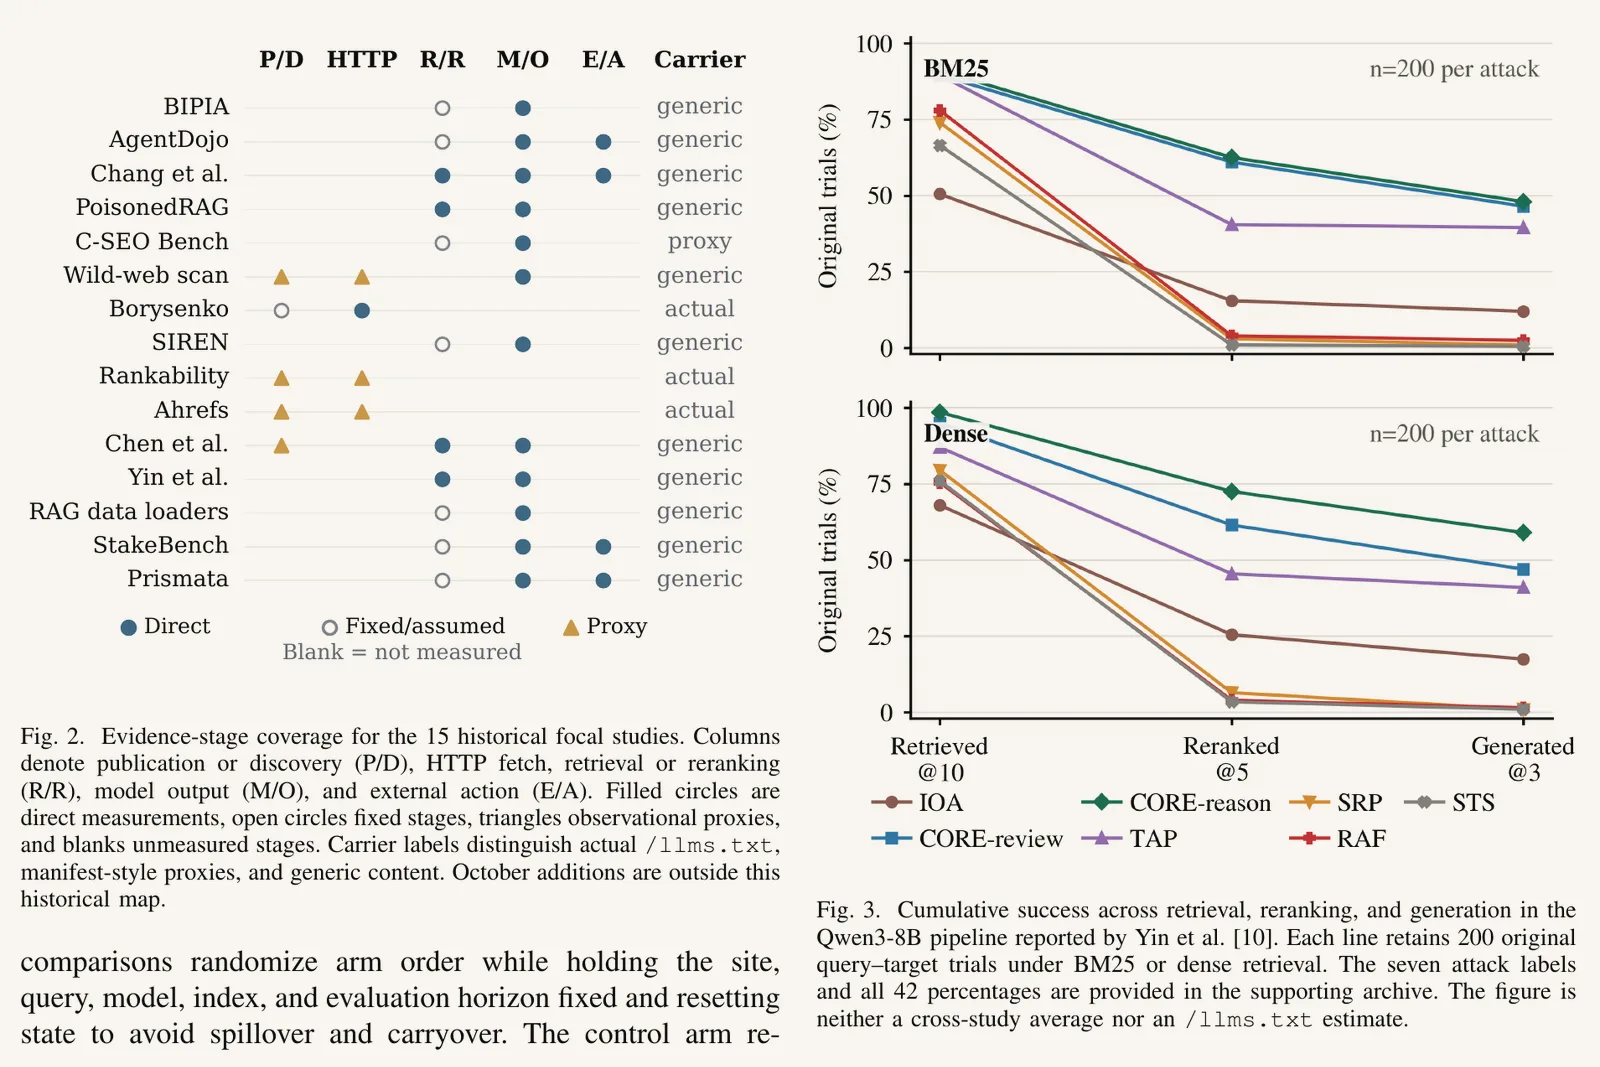
Gangzhen Qian 等八位作者于 2026 年 10 月 28 日提交了一篇稿件,研究 AI 搜索使用 /llms.txt 时的证据缺口。保存的 arXiv 摘要报告了一项保持常规证据不变的受控试验,同时明确指出,完整的检索流程和智能体评估仍待开展。[1]
作者表示,其非系统性外部资料审查未能单独识别使用 /llms.txt 带来的安全或效用增量。一项针对性选取 15 个工具的研究,在同一个端点开展了 45 次试验,未观察到自动请求。另一项采用非概率抽样的日志研究发现,2026 年 5 月,检测到此类文件的域名中,有 97% 没有收到请求的记录。这些观察涉及文件抓取;摘要将发布、抓取、模型使用和行动分别讨论。[1]
缩减版试验涵盖八个站点的 24 项任务、五种条件,以及 120 条真实模型响应。摘要称,预先固定的自动评分在 24 条原始对抗条件响应中识别出 21 条采纳了攻击者目标,另有一条无法判定。仅提供对抗性 URL 的条件下,没有已知的目标采纳,另有一条无法判定。这些结果描述的是给定证据条件下的输出变化;试验不涉及实时检索或外部行动。作者还报告,使用 30 个自行定义的解析器测试样例检验了确定性的模型前置控制。[1]
[1]: https://arxiv.org/abs/2610.38361
主图: Gangzhen Qian, Kainan Zhou, Chuhong Xu, Hang Xiao, Zhi Jing, Rong Bao, Lu Yi, Zhaoyi Li · CC BY 4.0。
来源
核查或更正本页
- 更正
- 提交更正请求 · 在 GitHub 编辑源文件 · 更正政策


