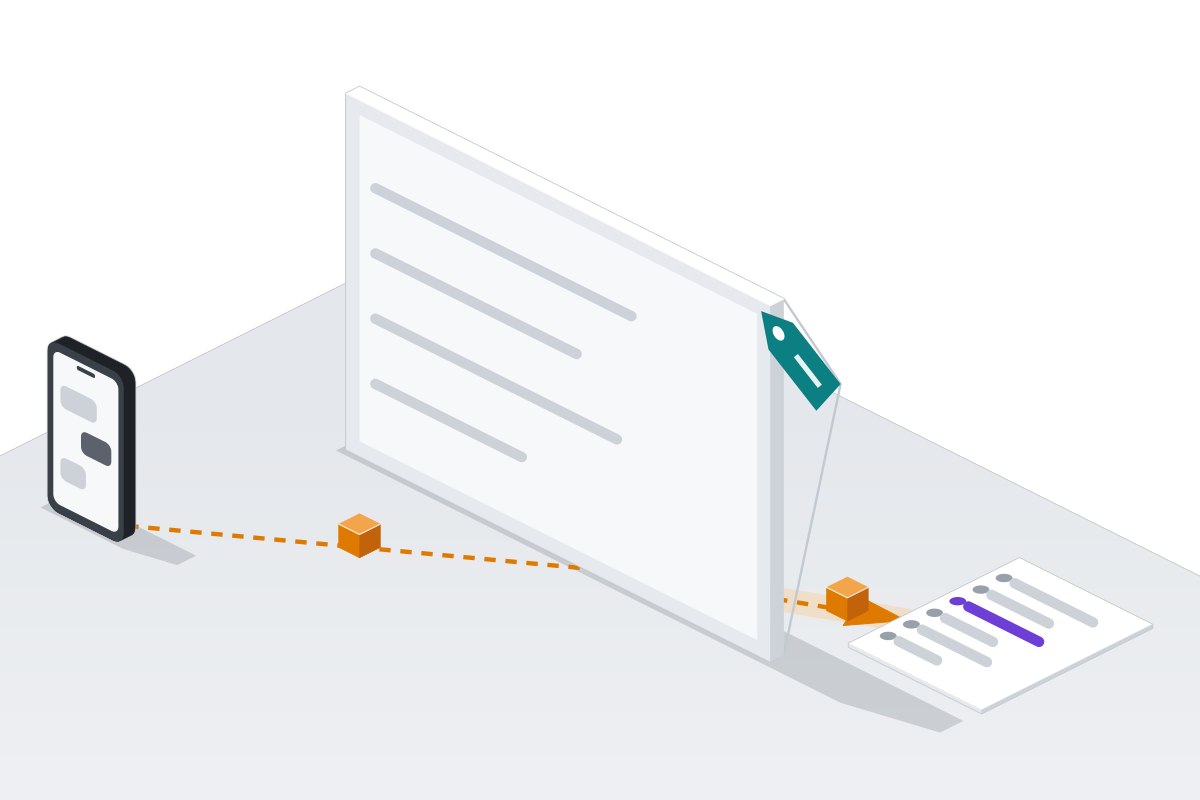
Donghang Duan 与另外五位作者于 2026 年 10 月 30 日向 arXiv 提交论文,报告称,即使无法访问用户对话,观察者也能从工具调用轨迹中推断用户属性。研究对象是通过模型上下文协议(MCP)与外部工具交互的智能体。论文所述风险来自符合协议的交互,无需构造格式异常的工具调用。[1]
作者提出了 PrivacyTrace 基准,包含 1,000 个合成用户画像,以及覆盖四个领域的 4,000 条智能体执行轨迹。这些轨迹使用来自 25 个服务器的真实 MCP 工具生成。摘要称,以四种主流大语言模型作为攻击者时,画像推断攻击成功率为 26.25%,基于先验的猜测则为 17.97%。这些数字是作者报告的实验结果;保存的页面没有提供足够的方法细节,无法据此独立评估这项比较。[1]
据摘要介绍,工具参数和返回结果是轨迹中支持推断的主要证据,跨会话关联轨迹还会加大画像推断风险。作者表示代码和数据已公开,并呼吁为智能体与工具的交互开发注重隐私的机制。保存的摘要没有列出修复版本,也没有给出经过验证的缓解措施。[1]
[1]: https://arxiv.org/abs/2610.41885
主图: Donghang Duan, Qingyu Liu, Yifei Liu, Na Zou, Xia Hu, Dongrui Liu · CC BY 4.0。
来源
核查或更正本页
- 更正
- 提交更正请求 · 在 GitHub 编辑源文件 · 更正政策


