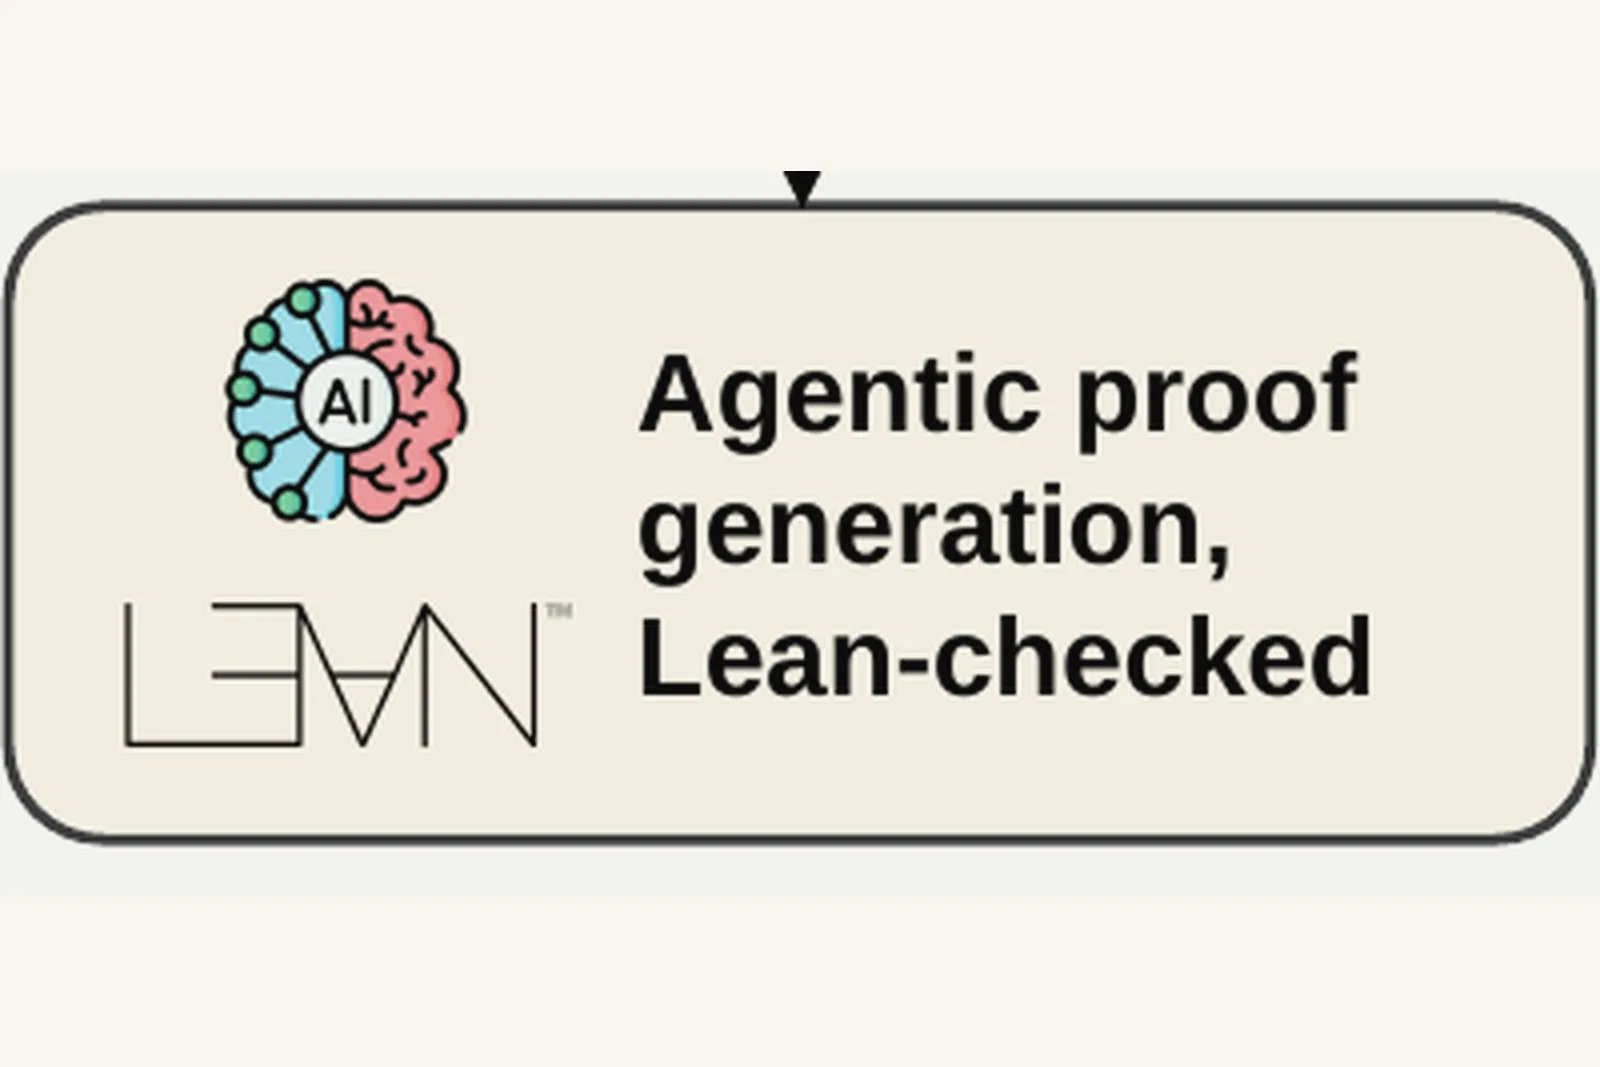
2026 年 11 月 1 日,Zixi Zhang 等作者提交了 LARK 论文。该框架结合大语言模型(LLM)智能体与 Lean 4,对照 PyTorch 参考实现,对 GPU 内核进行形式化核验。作者声称,它能在精确算术假设下建立功能行为与内存行为的等价性;这一假设也限定了正确性结论的范围。[1]
摘要介绍,LARK 针对每种目标语言,预先用 Lean 4 形式化 GPU 机器模型和操作语义,再从这些定义推导待核验内核的语义。智能体先把内核拆分成较小的片段,由 Lean 检查拆分是否成立;随后,智能体编写数学证明,说明各片段与对应的 PyTorch 实现一致。作者称,这两个步骤共同建立整个程序的等价性。内核生成之前,仍需人工审查算子层面的 Lean 语义。[1]
作者报告,在 KernelCraft 任务中,配合一个简单的 ReAct 智能体,LARK 使 GLM 5.3 完成了 12 个 Level-1 内核中 10 个的完整核验,Opus 5.5 则完成了全部 5 个 Level-2 内核的核验。作者还称,从常用开源 LLM 服务框架中随机抽取的 10 个生产内核,有 9 个通过核验,第 10 个被发现存在新的数据竞争缺陷。这些均为论文报告的结果,本文未独立复现。[1]
[1]: LARK: Lean-Assisted Reasoning for LLM-Generated GPU Kernels。arXiv,2026 年 11 月 1 日提交。https://arxiv.org/abs/2611.02028
主图: Zixi Zhang, Jiayi Nie, Haoran Wu, Yujie Yan, Yann Herklotz, Rika Antonova, Robert Mullins, Yiren Zhao, George A. Constantinides, Jianyi Cheng · CC BY 4.0。
来源
核查或更正本页
- 更正
- 提交更正请求 · 在 GitHub 编辑源文件 · 更正政策