---
title: "FLASH:在 NVIDIA H100 上为机密 LLM 推理建立检查点"
dek: "FLASH 复用 GPU 密文,并通过 UVM 跟踪脏页,以缩短检查点暂停。基于 H100 与 Intel TDX 的评测分别考察暂停延迟、服务影响和恢复时间。"
disclosure: "verifiable.pro 编辑 Mengyuan Li 是 FLASH 论文的合著者。"
---
FLASH 为大语言模型(LLM)推理保存受保护的数据状态,使服务不必在每次创建检查点时,都暂停下来转储整个图形处理器(GPU)的内存。它结合了 GPU 已生成密文的复用和驱动层的内存修改跟踪。它要解决的运维问题是:保留正在处理的请求,同时减少保存状态对服务造成的干扰。[^1]
Jonghyun Lee 及其同事面向 ACM SIGOPS ATC 2026 的 [FLASH 最终论文](https://github.com/sept-usc/FLASH/blob/cfe082f3fa9d6f68374b312c934fc86668ffc510/docs/flash-atc2026.pdf),在单张机密模式 H100 上评估了这一方案。理解结果时,需要分别看待检查点暂停、后台复制对请求的影响,以及此后的恢复耗时。[^1]
## 为什么保护机制让状态保存变慢
推理会建立键值(KV)缓存,保存此前处理的词元所产生的注意力状态。丢失缓存意味着活跃请求已经完成的工作被丢弃。从提示词重新计算会重复处理,而随机词元采样可能产生不同的后续输出。检查点保存了从指定位置继续处理所需的数据。[^1]
机密推理将中央处理器(CPU)和 GPU 放在可信执行环境(TEE)内,旨在保护其中的数据,使恶意云运营者无法在威胁模型范围内读取。在论文评估的 H100 配置中,外围组件互连高速接口(PCIe)仍不可信,因此 GPU 数据离开受保护内存前必须加密。[^1]
常规安全检查点会在 CPU TEE 内解密传来的密文,再用检查点密钥加密待保存的状态。论文测得,非机密模式下的传输带宽约为 40 GB/s,机密模式下约为 7.3 GB/s。按后者传输 80 GB,仅数据搬运就需要约 11 秒,还未计入额外的检查点加密。[^1]
## 保留 GPU 已经完成的加密
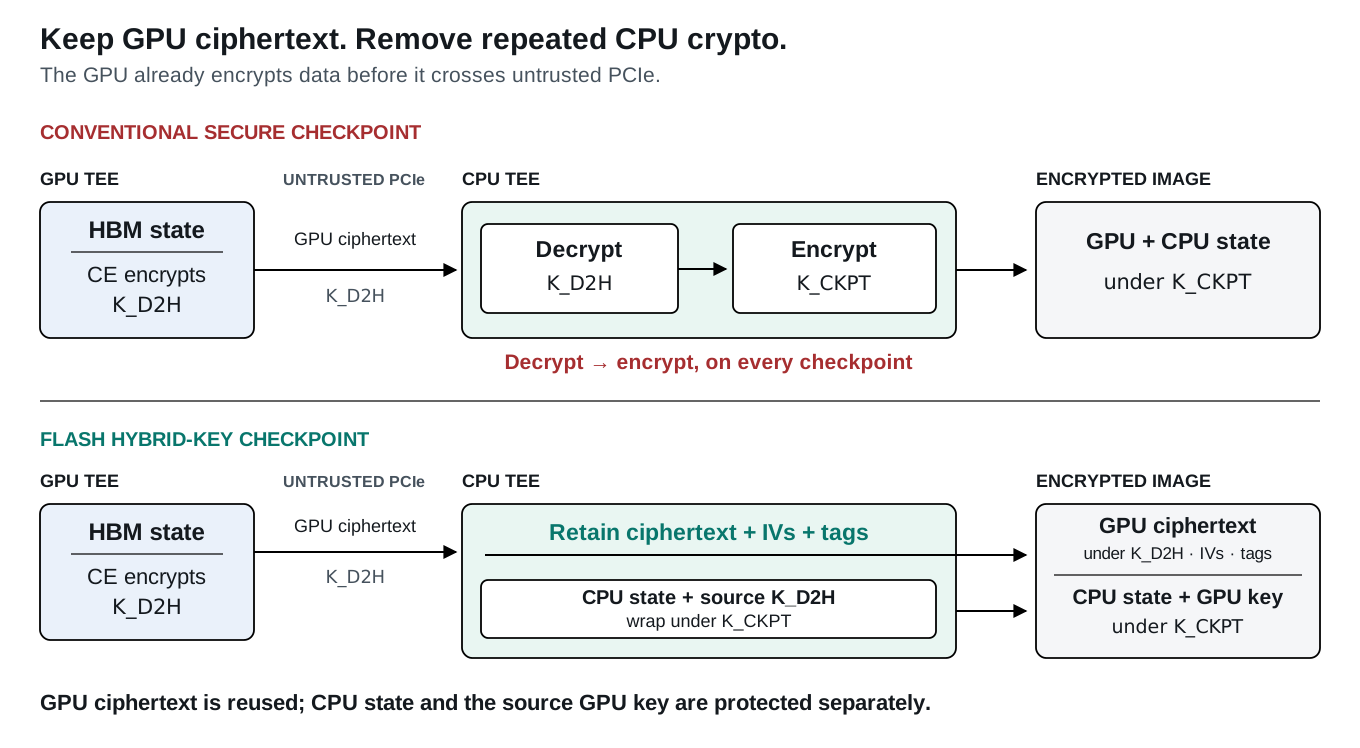 查看大图 · 混合密钥检查点保留 GPU 密文,分别保护 CPU 状态和源 GPU 密钥。改绘自 FLASH 论文图 4。 图源 · CC BY 4.0.
FLASH 保留 GPU 复制引擎生成的设备到主机密文。自定义驱动接口同时提取加密页面、初始化向量(IV)和认证标签,从而在创建检查点时省去 CPU 上重复的解密和重新加密。[^1]
因此,检查点镜像包含两个保护域。GPU 页面继续由源 GPU 会话密钥加密;CPU 状态和该源密钥则由检查点密钥加密。保存的 IV、认证标签和元数据,让恢复程序能够重建原始解密上下文。[^1]
恢复仍需执行密码运算。目标端取得检查点密钥,解封源 GPU 密钥,并在受保护的 CPU 内存中认证和解密保存的 GPU 页面。将页面装入目标 GPU 时,数据使用目标端新建的受保护传输会话。保留密文加快了反复保存状态的过程,恢复时仍需重建和解密。[^1]
## 在推理继续时发现写入
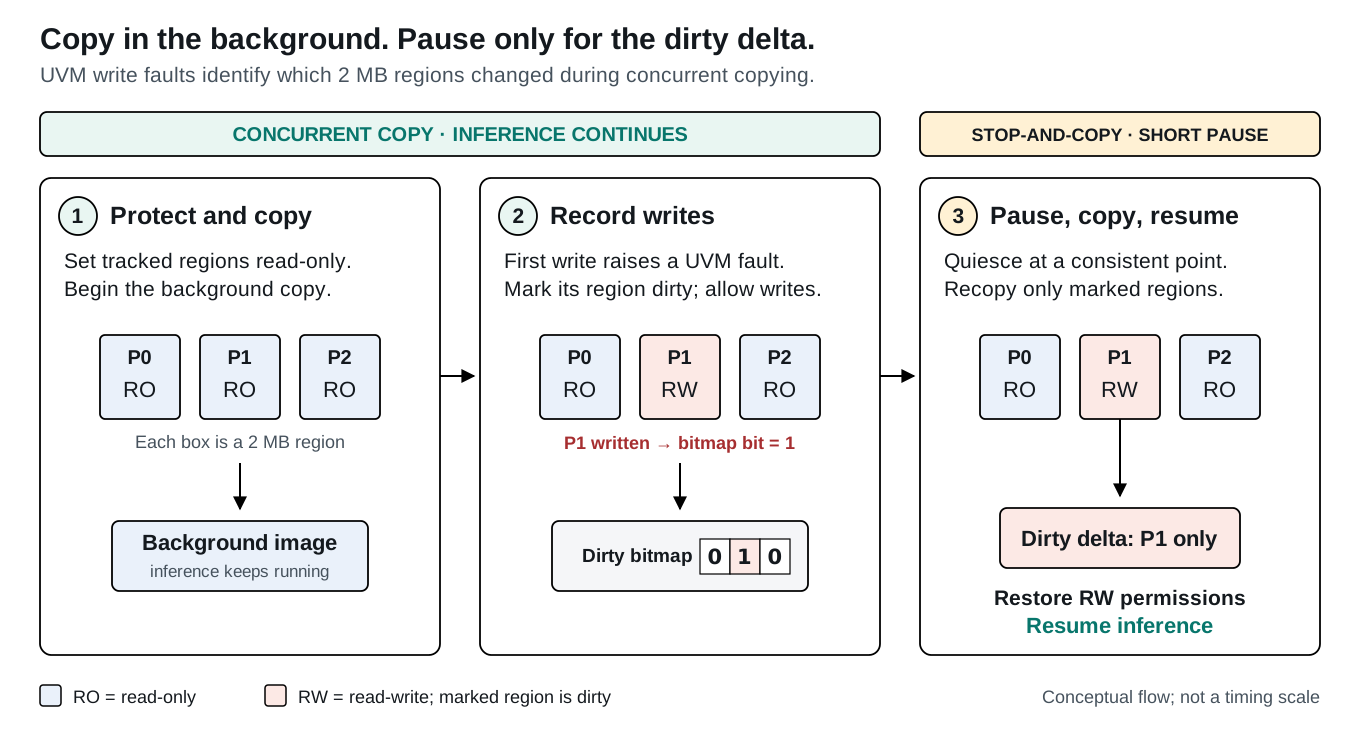 查看大图 · UVM 脏页跟踪与并发复制:最后暂停时补拷修改过的 2 MB 区域。改绘自 FLASH 论文图 5。 图源 · CC BY 4.0.
大部分复制与推理并行进行。由于推理可能修改已经复制过的页面,FLASH 必须找出哪些页面需要在最后暂停时再次复制。[^1]
FLASH 拦截内存分配调用,将其替换为 NVIDIA 统一虚拟内存(UVM)管理的分配,再将这些内存预取到 GPU。被跟踪的页面设为只读;写入会触发故障,使客户机驱动能够记录被修改的区域,并恢复写权限,让执行继续。[^1]
FLASH 以 2 MB 为粒度跟踪。一个区域首次发生故障时,它会主动按较大区域处理,避免潜在的数百次独立 4 KB 故障处理。这会把部分未修改字节也计入脏数据,但减少了故障处理成本。该机制无需修改 LLM 内核,也无需离线分析并行线程执行(PTX)代码。[^1]
到达被拦截的框架同步点时,尚未完成的 GPU 工作已经排空。FLASH 暂停执行,复制累计的脏区域,然后恢复服务。跟踪窗口部分取决于应用何时到达同步点,因此可能长于后台复制本身。[^1]
## 复用静态数据,恢复时仍完整装载
模型权重通常在加载后保持不变。论文中的静态分类机制只捕获一次这类状态,并在后续检查点中复用。静态页面仍受监测:后续写入会触发故障,将相关区域提升为动态状态。恢复时会装载静态和动态数据,也会恢复重启后的框架所需的请求元数据。[^1]
发布代码中有一项需要保留的实现区别。默认 `v3-static` 模式通过主机到设备的分配标志识别静态分配;学习路径需要单独启用 `--learn`。使用默认模式的运行,不能被描述为自动使用了论文中的学习机制。[^2]
## H100 测量结果说明了什么
评估使用一张处于机密模式的 80 GB NVIDIA H100、Intel 信任域扩展(TDX)和 vLLM 0.8.5。模型包括 Llama-3.2-1B、Qwen-2.5-7B 和 Llama-2-13B,负载分别为短上下文 Chatbot 和长上下文 Reasoning。镜像暂存在以内存为后端的 `tmpfs` 中,负载生成器绕过了网页服务层。[^1]
论文对 FLASH 和去除静态分类的 FLASH-SC 汇总后,报告 stop-and-copy(暂停补拷)阶段的平均耗时为 1.2 秒。论文报告,相比 PhoenixOS(PhOS)缩短 9.4 倍,相比采用一分钟检查点间隔的 GCR 缩短 7.8 倍。由于原系统不能在这套机密软件栈上原样运行,比较采用了重新实现的数据路径。测量对象是作者在共同配置下对这些比较协议的实现。[^1]
检查点间隔为一分钟时,服务开销随负载显著变化。在 Llama-1B Reasoning 负载中,FLASH 的第 99 百分位首词元时间为 75.8 毫秒,PhOS 为 14,364.9 毫秒,GCR 为 6,385.6 毫秒。然而,在一分钟间隔的 Llama-1B Chatbot 场景中,FLASH 的第 95 百分位首词元时间约为 13.3 秒,比两个比较方案都差。写故障跟踪也增加了词元间时间。检查点暂停较短,并不意味着服务开销在所有负载下都低。[^1]
恢复是另一项测量。三个模型恢复约 66–67 GB 的完整状态,分别耗时 18.7、17.1 和 18.1 秒。静态分类不会免除恢复时的权重传输。[^1]
## 完整性和新鲜性依赖可信服务
仅有加密无法拒绝一个有效但过时的检查点。FLASH 将认证加密与清单结合,清单绑定页面位置和密码元数据。TDX 签名报告绑定清单哈希、机密虚拟机身份、检查点计数器和时间戳。可信远程证明服务(RAS)保留检查点密钥,以及最新计数器和清单哈希;恢复时会拒绝与该记录不符的镜像。[^1]
这依赖 CPU 和 GPU 保护机制、客户机内核、驱动、检查点程序及 RAS 正确工作。RAS 必须在客户机销毁后继续保留可信状态,并处于攻击者控制范围之外。远程证明提供环境所加载软件的证据,绝不保证运行时行为正确。本站的[面向 AI 工作负载的远程证明解读](/articles/remote-attestation-for-ai-workloads-explained/)和[远程证明报告阅读指南](/articles/how-to-read-a-remote-attestation-report/)进一步解释了这一区别。
可用性,以及数据量、访问模式和时间信息的泄漏,均不在 FLASH 的保护范围内。恶意主机可以扣留镜像或拒绝提供服务。所需状态不可用时,协议会停止操作,不会放宽检查继续执行。[^1]
## 部署边界
FLASH 保存推理数据状态,并通过重启框架重建执行上下文。它不提供通用 GPU 控制状态快照,跨多张 GPU 的全局一致检查点也不在评估范围内。未来的可信输入输出路径,还可能消除其密文复用优化所依赖的中间密文。[^1]
[FLASH 仓库](https://github.com/sept-usc/FLASH)及其[配图 README](https://github.com/sept-usc/FLASH/blob/main/README.md) 提供驱动修改和评估程序。发布内容未提供完整的生产级 RAS 和密钥释放服务部署,这些需要额外集成。[^2] [会议制品评估记录](https://sysartifacts.github.io/atc2026/results)列出了 Artifacts Available、Artifacts Evaluated – Functional 和 Results Reproduced 三项徽章。[^3] [归档评估制品](https://doi.org/10.5281/zenodo.23199897)保存了该发布版本。[^4] 本站的[已公开私有 AI 计算设计比较](/articles/private-ai-compute-published-designs/)提供了更广泛的背景,帮助区分机制能力与部署主张。
:::analysis
FLASH 展示了如何利用现有加密传输路径,为可恢复的机密推理缩短检查点暂停。部署判断仍取决于负载表现、完整的恢复集成,以及能够持久保存可信状态的新鲜性服务。论文报告的暂停时间只是评估的一部分。
:::